HPCシステムズではエンジニアを募集しています。詳しくはこちらをご覧ください。
HPCシステムズのエンジニア達による技術ブログ

Tech Blog

ベンチマーク

HPC

『機械設計』10月号にHPCシステムズ社員による寄稿記事が掲載されました

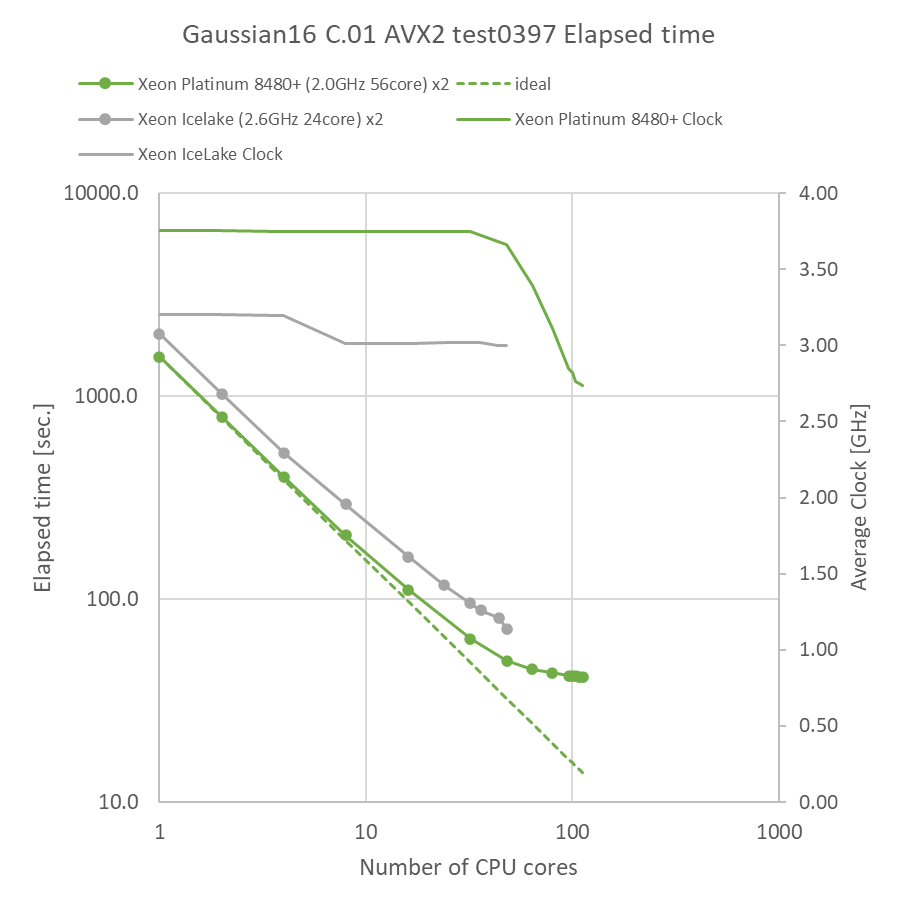
こんにちは!HPC事業部 技術グループの渡邊です。モノづくりの一線で活躍する機械設計者を支援する実務雑誌『機械設計』10月号(日刊工業新聞社)において、渡邊 啓正(わたなべ ひろまさ)が執筆・寄稿した記事が掲載されました。同誌の Technical Report として、渡邊は「なぜ高性能CPU を搭載してもCAE は速くならないのか」を執筆しました。近年、CPUのコア数は増加の一途にありますが、並列数を大きくしてもCAE解析計算が速くならない場合があります。本稿ではその原因をプロファイリングによって読み解き、CAE解析計算を効率よく速く行うための理論と実践を述べています。全国の書店、およびオ...
HPC

インテル Xeon 6 プロセッサー ベンチマーク

概要2025年2月24日(日本時間25日)、インテル🄬 Xeon🄬 6 プロセッサー(P-core採用6900/6700/6500シリーズ、開発コード名:Granite Rapids)がリリースされました。Intel 3製造プロセスにより微細化されて、1ソケットに最大72~128コア(SKUによって異なります)と、最大504MBの大容量 LLCを搭載可能になりました。さらに、1ソケットあたりのメモリチャンネル数が12本へ増加し、転送レートDDR5-6400 MT/sをサポートした他、新たに、より広帯域なDDR5-8800 MT/sのMultiplexed Rank DIMM(以下、MRDIMM...
産業用コンピューティング

秋の夜長にUbuntuでベンチマーク三昧!

あなたも私もベンチマークが好き本ブログの読者の中にもベンチマーク好きの方は多いと思いますが、「Windowsには豊富なベンチマークがあり、簡単に実行できるけれど、Linuxではなかなか見つからないな…」と感じたことはありませんか?Windowsであれば、「窓の杜」などで主要なベンチマークが簡単に見つかりますし、海外の有名PC情報サイトにもベンチマークのリンク集があります。窓の杜Guru3D.com(Guru3Dはグラフィック系が豊富)TechPowerUp(TechPowerUpは海外の定番リソース)しかしながら、Linuxでは「ベンチマークソフトを見つけにくい」「計測したい性能を測定できるツ...
DL

L40S, H100 NVL上でのLLM推論学習検証報告

目的ローカルLLMを用いた生成AI活用に向けて、推論を中心としたパフォーマンス(体感速度、同時アクセス数)を明らかにすべく、ベンチマーク検証を行いました。ハードウェアの決定のために最低限必要な情報は「どのGPUを何枚で」どのモデルが動くかです。対象モデルは、現状精度の高い Llama 3.1 8B、Llama 3.1 70B、Gemma 2 9B、Gemma 2 27B としました。検証・結果 ユーザーの体感速度検証方法 各条件で1つのRequestを処理した際の、Throughput (token/sec) を計測 対象モデル:Llama 3.1 8B, Llama 3.1 70B、Gemm...
DL

高速なDNN学習計算のためのハードウェア構成ポイント

概要深層学習にGPUが好適とよく言われていますが、比較的安価なGPUからハイエンドのものまで様々なGPUがある中で、深層学習計算の高速化にどのようなハードウェア構成が適しているのでしょうか。GPUのスペックを見ると、理論性能値に加えてGPUメモリ容量、GPUメモリ帯域幅も様々ですし、複数GPU間の高速通信を可能とするNVLinkもあります。これらの選択肢がある中で、どの指標を優先的に考慮すべきなのでしょうか。本稿では、DNNの学習計算について、ベンチマーク結果からその答えを導いてみます。ベンチマーク環境本稿で用いるデータは弊社内で過去に取得したベンチマークからとなりますため、2024年現在の現...
HPC

第5世代 インテル Xeon スケーラブル・プロセッサー ベンチマーク

ベンチマーク報告書(PDF)のダウンロードはこちらからどうぞ!概要2023年12月14日(日本時間15日)、第5世代 インテル🄬 Xeon🄬 スケーラブル・プロセッサー(開発コード名:Emerald Rapids)がリリースされました。「Intel 7」製造プロセスにより微細化されており、1ソケットに最大64コアを搭載可能になったことに加え、CPU間のUPI接続速度が20 GT/sに向上しました。また、コア間で共有されるLast Level Cacheの容量が320MBに拡大し、メモリアクセスを多用するAI・HPCワークロード向けに機能強化されています。さらに、新たにDDR5-5600のメモリ...
DL

NVIDIA GH200 MLベンチマーク公開

NVIDIA GH200 の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、NVIDIA H100-PCIEと A6000 を加えた計3種のGPUで、機械学習の学習性能を比較評価しています。ベンチマーク報告書のダウンロードはこちら >>スペック情報NVIDIA GH200、NVIDIA H100-PCIE、NVIDIA A6000 のスペック比較表は次のとおりです。GPU型番NVIDIA GH200NVIDIA H100-PCIENVIDIA A6000アーキテクチャHopperHopperAmpereGPU ベースクロック990 MHzGPU Boost 時クロック1755...
DL

NVIDIA A800 MLベンチマーク公開

NVIDIA A800(40GB Active) の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、NVIDIA A100 を加えた計2種のGPUで、機械学習の学習性能を比較評価しています。ベンチマーク報告書のダウンロードはこちら >>スペック情報NVIDIA A800、NVIDIA A100 のスペック比較表は次のとおりです。GPU型番NVIDIA A80040GB ActiveNVIDIA A10080GB PCIeアーキテクチャAmpereAmpereGPUベースクロック765 MHz765 MHzGPU Boost時クロック2100 MHz1410 MHzCUDAコア...
HPC

SLC採用、高速NVMe™ SSD KIOXIA FL6 レビュー

はじめに今回、KIOXIA社が横浜に開設したKIOXIA Innovation Labを利用して、SLC(Single Level Cell)を採用した高速NVMe™ SSD、FL6をリモート評価させていただく機会をいただきました。 KIOXIA Innovation LabとはKIOXIA Innovation Labは、KIOXIA社が提供するクラウド型のKIOXIA製品PoC施設です。KIOXIA社の最新SSDや関連技術、ソフトウエアを評価できる環境を利用することが可能です。リモートからVPN接続しWebブラウザだけで利用可能でした。 KIOXIA FL6 NVMe™ SSDとは今回評価...
DL

RTX A5500、RTX 5000 Ada MLベンチマーク公開

NVIDIA RTX A5500 と RTX 5000 Ada の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、これらのGPUに NVIDIA A6000 と RTX 4090 を加えた計4種のGPUで、機械学習の学習性能を比較評価しています。スペック情報NVIDIA RTX A5500、RTX 5000 Ada、RTX A6000、GeForce RTX 4090 のスペック比較表は次のとおりです。青文字は資料などからの推測値です。GPU型番NVIDIA RTX A5500NVIDIARTX 5000 AdaNVIDIARTX A6000GeForceRTX 4090アー...
DL

NVIDIA L40S MLベンチマーク公開

NVIDIA L40S の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、NVIDIA A100 を加えた計2種のGPUで、機械学習の学習性能を比較評価しています。ベンチマーク報告書のダウンロードはこちら >>スペック情報NVIDIA L40S、NVIDIA A100 のスペック比較表は次のとおりです。青文字は資料などからの推測値です。GPU型番NVIDIAL40SNVIDIA A100アーキテクチャAda LovelaceAmpereGPUベースクロック765 MHzGPU Boost時クロック2520 MHz1410 MHzCUDAコア数181766912TensorCo...
HPC

第4世代 AMD EPYC 97X4 プロセッサー ベンチマーク

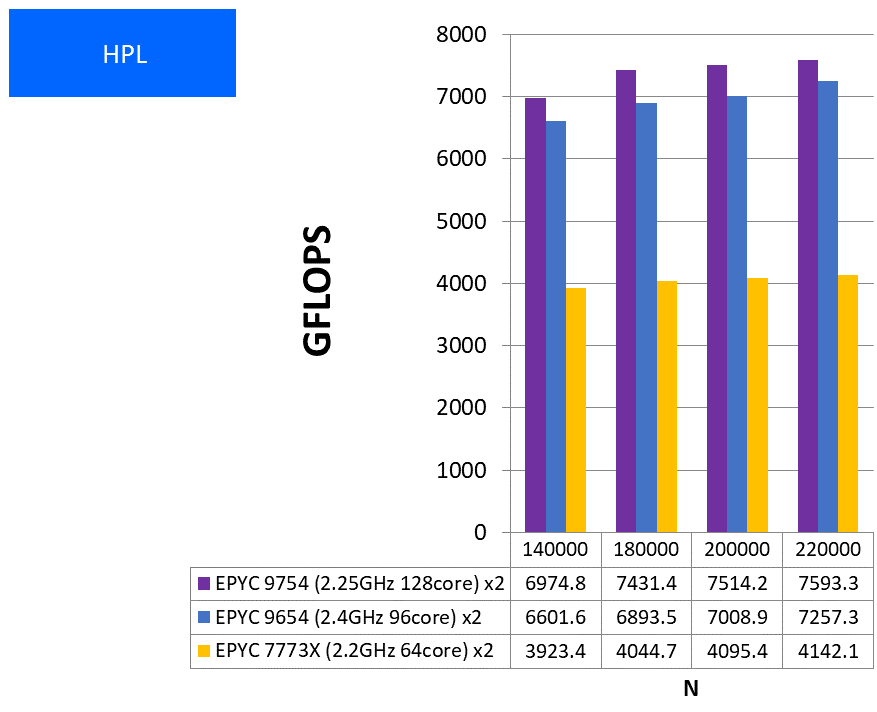
ベンチマーク報告書(PDF)のダウンロードはこちらからどうぞ!概要2023年6月13日、新コアを採用した第4世代 AMD EPYC™ 97X4 プロセッサー(開発コード名:Bergamo)がリリースされました。開発コード名Genoaの第4世代 AMD EPYC™ プロセッサーと比べると、論理的には「Zen 4」と同じながら物理設計を変更してCPUコアのエリアサイズが縮小されている、従来の4MB/コアから2MB/コアに3次キャッシュが縮小されている、1つのダイに2つのCCXが搭載されそれらがIoD経由で通信される、といった差異があります。この新プロセッサーは元々クラウドのワークロード向けプロセッ...
産業用コンピューティング

第11世代CPU(Z590)&第12世代CPU(Z690)のCPU性能テスト/比較

第12世代Coreプロセッサーについて 第12世代第11世代コア構成高性能コア+高効率コア高効率コアのみ(Core i5 Kなし以下)高性能コアのみコア/スレッド(最大)Core i9 : 16コア/24スレッドCore i7 : 12コア/20スレッドCore i5 K : 10コア/16スレッドCore i5(Kなし) : 6コア/12スレッドCore i3 : 4コア/8スレッドCore i9 : 8コア/16スレッドCore i7 : 8コア/16スレッドCore i5 : 6コア/12スレッド対応メモリDDR5-4800DDR4-3200DDR4-3200PCIe5.04.0内蔵GP...
HPC

VASP 6.4.1 : libxcの使用

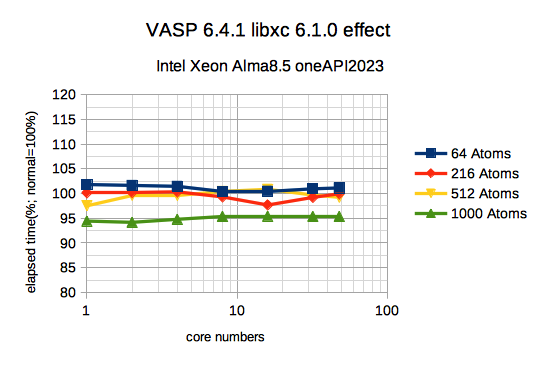
VASP 6.4.1がリリースされました。実はvasp 6.3.0からlibxcが使用可能なのですが、vasp 6.4.1に最新のlibxc 6.1.0を組み込んで、libxcを使用した場合、実行時間が早くなるかを試験しました。libxcに関しては、 をご参照下さい。使い方は簡単で、インプット(INCAR)でGGA=PAとしている部分をGGA = LIBXCLIBXC1 = GGA_X_PBELIBXC2 = GGA_C_PBEと変更するだけで、VASPビルド時にlibxcが組み込んであれば、VASPの内部でlibxcが呼ばれて使用されます。VASPでの使い方等の詳細は、 や  にあります。l...
HPC

第4世代 インテル Xeon スケーラブル・プロセッサー ベンチマーク

※2023年5月17日に改めて公開いたしました。ベンチマーク報告書(PDF)のダウンロードはこちらからどうぞ!概要2023年1月10日(日本時間11日)、第4世代 インテル🄬 Xeon🄬 スケーラブル・プロセッサー(開発コード名:Sapphire Rapids)がリリースされました。「Intel 7」製造プロセスにより微細化され、1ソケットに最大56コアを搭載可能になったことに加え、CPU間のUPI接続がCPUあたり最大4本に増加し、その速度が16 GT/sに向上しました。また、新たにDDR5-4800のメモリに対応して、より太いメモリ帯域に進化しました。さらに、データ移動のための専用アクセラ...
HPC

VASP 6.4.1 : on the fly 機械学習力場

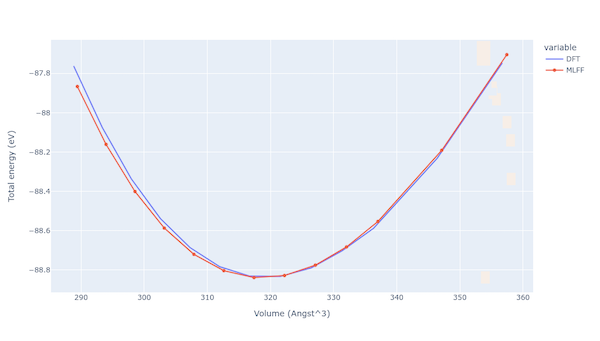
vasp 6.4.1がリリースされましたが、このバージョンで特に強化されているのが、機械学習力場の機能部分です。この機械学習力場を上手く活用すると、大変な計算時間の短縮になるので紹介します。機械学習力場というと、「力場で計算した結果は信用出来ない」とか、「機械学習ならGPUが必要でしょ?高価なGPUは購入予定が無いので。」といった事を思われるかもしれません。力場の使用に関しては、自分が計算したい系を扱った力場で適切なものを選択するのが大変で、その選定や差異などをチェックするところでとても手間と計算リソースを消費する為、力場で計算する事で省力化可能より手間が大きくなりそうに思えるという事はあるか...
DL

NVIDIA H100, GeForce RTX 4090 MLベンチマーク公開

NVIDIA H100 と GeForce RTX 4090 の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、これらのGPUに NVIDIA A100 と RTX 3090 を加えた計4種のGPUで、機械学習の学習性能を比較評価しています。スペック情報NVIDIA H100 PCIe、NVIDIA A100 PCIe、GeForce RTX 4090、GeForce RTX 3090 のスペック比較表は次のとおりです。CUDAコア数とGPU Boost時クロックが向上していることがわかります。GPU型番NVIDIAH100-PCIENVIDIA A100-PCIEGefor...
HPC

第4世代 AMD EPYC プロセッサー ベンチマーク

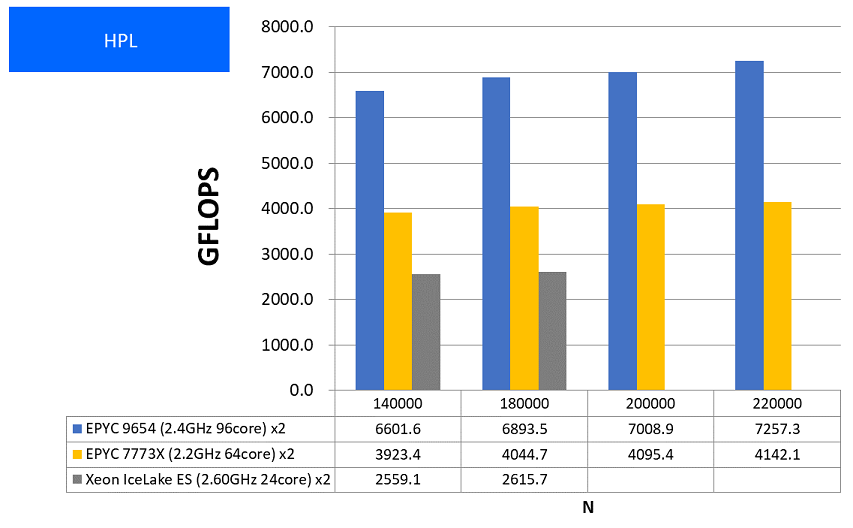
ベンチマーク報告書(PDF)のダウンロードはこちらからどうぞ!概要2022年11月10日、第4世代 AMD EPYC™ プロセッサー(開発コード名:Genoa)がリリースされました。新マイクロアーキテクチャ「Zen 4」を採用し、5nm製造プロセスにより微細化されて、1ソケットで最大96コア、2ソケットで最大192コアという多コア構成が可能になったことに加え、DDR5-4800メモリに対応してメモリチャンネルが12本に増えたことでメモリ帯域も太く構成されている点が特長です。また、AVX-512命令に対応してAI・HPCワークロード向けに機能強化された他、キャッシュ階層と分岐予測の改善によってI...
HPC

Core i9-12900KでのGaussianベンチマーク

第12世代インテル® Core™ i9プロセッサーの12900Kは、Performance-core(P-core)を8個・Efficient-core(E-core)を8個搭載したデスクトップPC向けハイエンドプロセッサーです。実計算における性能を明らかにするため、量子化学計算のデファクトスタンダードであるGaussian16にてベンチマークを行いました。ベンチマーク環境サーバー: HPC2000-CAL104TACPU: Intel® Core™ i9-12900Kメモリ: 32GB DDR5-4800 ECC UDIMM x2ソフトウェア: Windows 11 Proアプリケーション:...
DL

Geforce RTX4090 ベンチマーク

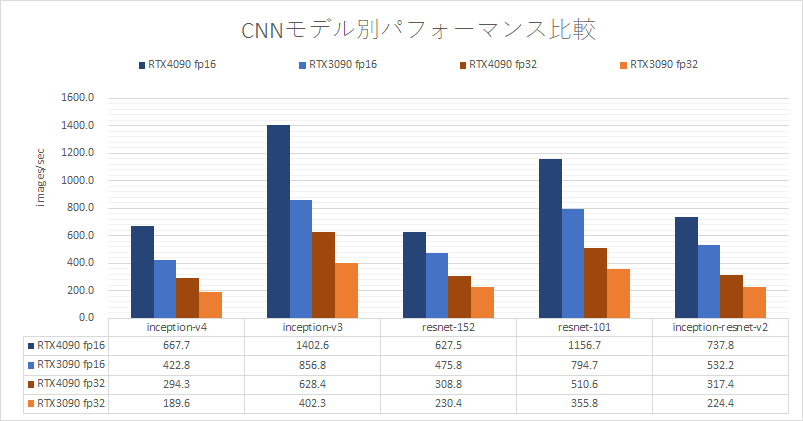
Ada Lovelace アーキテクチャ Geforce RTX 4090は、新型GPUアーキテクチャ「Ada Lovelace」を採用する初めてのGPUです。製造プロセスが4nmになり微細化が進み、GPUコア数、周波数が劇的に伸びました。また、Tensorコアは第4世代となり、FP8演算エンジンも搭載されました。RTX4090スペック今回、比較したGeforce RTX3090と、Geforce RTX4090のスペックを下表にまとめました。 Geforce RTX 4090Geforce RTX 3090アーキテクチャAda Lovelace AD102Ampere GA102GPU Bo...