HPCシステムズではエンジニアを募集しています。詳しくはこちらをご覧ください。
HPCシステムズのエンジニア達による技術ブログ

Tech Blog

AI

DL

Nemotron 3 Ultraの社内運用始めました

0.はじめにこんにちは!HPC事業部 技術グループのhinokiharaです。今年はAIの発展が目覚ましいですね!私もAnthropicのClaude Codeを毎日のように使用しており、働き方が劇的に変わりました。ただ非常に便利な一方で、会社の機密データや大事な研究データを読み込ませられない(読み込ませてしまった)という話もよく聞きます。機密性の高いデータを扱う場合はやはりローカルにLLMをホストしたい。でもローカルLLMはまだ性能が足りない。。。そんな悩みを持つ方は多いのではないでしょうか?今日はそんな悩みを持つ方々に、「ローカルLLMはここまで来たぞ」という話をしたいと思います。つい先日...
DL

AI・人工知能EXPOの様子

こんにちは!HPC事業部 技術グループのnabeoです。本日から3日間、AI・人工知能EXPOの『生成AI Hub』エリアに弊社出展しております。開会10:00すぐから足を運ばれたお客様もいらして、高い熱量が今年も続いています🔥お越しいただいたお客様と会話させていただいてわかったこととして、情報セキュリティなどを背景として、ローカルLLMの時代が現実味を帯びてきている実感があります。そして、展示している弊社ソリューションがそこに有効ということについても!金曜日4/17まで展示しております!ローカルLLMや生成AI導入を検討中の方、これからやってみようかなとお考えの方、どうぞお気軽にお越しくださ...
HPC

自社サーバーでのLLMに挑戦!ローカルLLM+RAG環境を構築してみた

はじめに近年、生成AIや大規模言語モデル(LLM)の活用がビジネス・研究・開発の現場でも急速に進んでいます。しかし、「実際にどう使えばいいのか分からない」「技術的なハードルが高そう」「セキュリティ上のリスクが高い」「回答の確からしさが保証できない」と感じている方も多いのではないでしょうか。 本記事では、LLMの概要からセキュリティ・カスタマイズ性に優れたローカルLLMの実践、RAGの実装までを解説します。 大規模言語モデル(LLM)とRAG (Retrieval-Augmented Generation)とは大規模言語モデル(LLM)は、膨大な量のテキストデータを学習することで、人間の言語を理...
DL

L40S, H100 NVL上でのLLM推論学習検証報告

目的ローカルLLMを用いた生成AI活用に向けて、推論を中心としたパフォーマンス(体感速度、同時アクセス数)を明らかにすべく、ベンチマーク検証を行いました。ハードウェアの決定のために最低限必要な情報は「どのGPUを何枚で」どのモデルが動くかです。対象モデルは、現状精度の高い Llama 3.1 8B、Llama 3.1 70B、Gemma 2 9B、Gemma 2 27B としました。検証・結果 ユーザーの体感速度検証方法 各条件で1つのRequestを処理した際の、Throughput (token/sec) を計測 対象モデル:Llama 3.1 8B, Llama 3.1 70B、Gemm...
DL

NVIDIA A800 MLベンチマーク公開

NVIDIA A800(40GB Active) の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、NVIDIA A100 を加えた計2種のGPUで、機械学習の学習性能を比較評価しています。ベンチマーク報告書のダウンロードはこちら >>スペック情報NVIDIA A800、NVIDIA A100 のスペック比較表は次のとおりです。GPU型番NVIDIA A80040GB ActiveNVIDIA A10080GB PCIeアーキテクチャAmpereAmpereGPUベースクロック765 MHz765 MHzGPU Boost時クロック2100 MHz1410 MHzCUDAコア...
DL

RTX A5500、RTX 5000 Ada MLベンチマーク公開

NVIDIA RTX A5500 と RTX 5000 Ada の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、これらのGPUに NVIDIA A6000 と RTX 4090 を加えた計4種のGPUで、機械学習の学習性能を比較評価しています。スペック情報NVIDIA RTX A5500、RTX 5000 Ada、RTX A6000、GeForce RTX 4090 のスペック比較表は次のとおりです。青文字は資料などからの推測値です。GPU型番NVIDIA RTX A5500NVIDIARTX 5000 AdaNVIDIARTX A6000GeForceRTX 4090アー...
DL

NVIDIA L40S MLベンチマーク公開

NVIDIA L40S の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、NVIDIA A100 を加えた計2種のGPUで、機械学習の学習性能を比較評価しています。ベンチマーク報告書のダウンロードはこちら >>スペック情報NVIDIA L40S、NVIDIA A100 のスペック比較表は次のとおりです。青文字は資料などからの推測値です。GPU型番NVIDIAL40SNVIDIA A100アーキテクチャAda LovelaceAmpereGPUベースクロック765 MHzGPU Boost時クロック2520 MHz1410 MHzCUDAコア数181766912TensorCo...
HPC

NVLink BridgeでGPUを繋いでも1GPUにはなりません

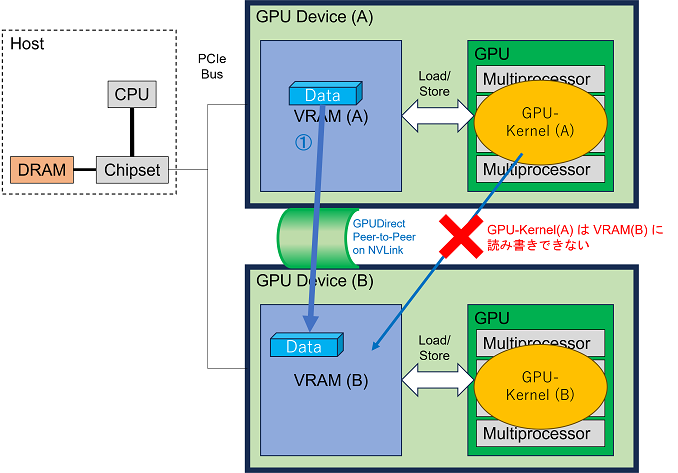
『NVLink Bridgeで複数GPUを繋いだら、それらが1GPUとして扱えるようになるんでしょ?』という誤解をされているお客様をしばしばお見受けいたします。こちらの記事では、それが誤解であること、また、SLIやUnified Memoryといった関連する情報についても整理して解説いたします。間違った期待を抱いて失敗しないように、正しい理解を深めていきましょう。GPUのメモリ空間は他デバイスから隔絶されていますGPU上には演算するためのプロセッサと、データを一時的に置いておくためのメモリ(VRAM)が搭載されています。GPUのメモリを、CUDAで書かれたプログラムから利用するには、cudaM...
HPC

VASP 6.4.1 : on the fly 機械学習力場

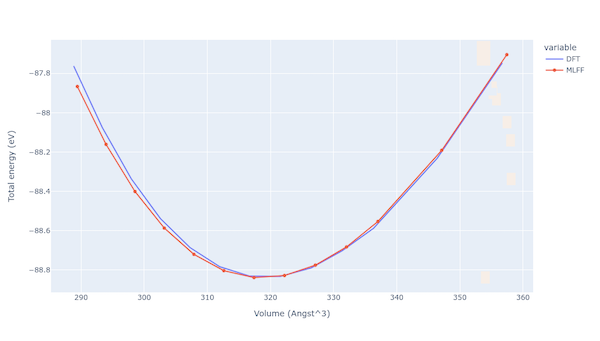
vasp 6.4.1がリリースされましたが、このバージョンで特に強化されているのが、機械学習力場の機能部分です。この機械学習力場を上手く活用すると、大変な計算時間の短縮になるので紹介します。機械学習力場というと、「力場で計算した結果は信用出来ない」とか、「機械学習ならGPUが必要でしょ?高価なGPUは購入予定が無いので。」といった事を思われるかもしれません。力場の使用に関しては、自分が計算したい系を扱った力場で適切なものを選択するのが大変で、その選定や差異などをチェックするところでとても手間と計算リソースを消費する為、力場で計算する事で省力化可能より手間が大きくなりそうに思えるという事はあるか...
DL

NVIDIA H100, GeForce RTX 4090 MLベンチマーク公開

NVIDIA H100 と GeForce RTX 4090 の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、これらのGPUに NVIDIA A100 と RTX 3090 を加えた計4種のGPUで、機械学習の学習性能を比較評価しています。スペック情報NVIDIA H100 PCIe、NVIDIA A100 PCIe、GeForce RTX 4090、GeForce RTX 3090 のスペック比較表は次のとおりです。CUDAコア数とGPU Boost時クロックが向上していることがわかります。GPU型番NVIDIAH100-PCIENVIDIA A100-PCIEGefor...
DL

Geforce RTX4090 ベンチマーク

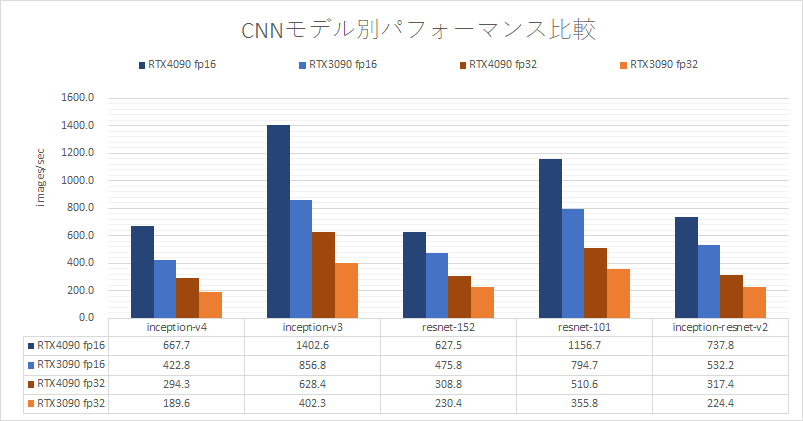
Ada Lovelace アーキテクチャ Geforce RTX 4090は、新型GPUアーキテクチャ「Ada Lovelace」を採用する初めてのGPUです。製造プロセスが4nmになり微細化が進み、GPUコア数、周波数が劇的に伸びました。また、Tensorコアは第4世代となり、FP8演算エンジンも搭載されました。RTX4090スペック今回、比較したGeforce RTX3090と、Geforce RTX4090のスペックを下表にまとめました。 Geforce RTX 4090Geforce RTX 3090アーキテクチャAda Lovelace AD102Ampere GA102GPU Bo...
HPC

ウェビナーへどうぞご参加ください!計算化学の最前線 ~富岳テクノロジーが加速するHPC・AI~のご案内

このウェビナーにはFX700や「富岳」などのA64FX環境での技術的な話題もありますので、Tech Blogでも紹介をさせてください。無料ウェビナー計算化学の最前線 ~富岳テクノロジーが加速するHPC・AI~弊社の講演者からは、FX700や「富岳」にて計算化学アプリケーションを安定動作させるため&高速化させるために行った試行錯誤をいくつか報告いたします。「富岳」をクラウド計算資源として実務に活用していく際にFX700がどのように役に立つかを、わかりやすさを大切にしながら説明いたします。「富岳」やHPCクラウドにご興味がございましたら、どうぞご参加ください!
DL

NVIDIA A100 ベンチマーク公開

Nvidia A100 のベンチマーク情報を公開しました。 今回は、CNNだけでなくBERTでもベンチマークしました。下からダウンロードページに飛びます。今回、アーキテクチャがAmpereへと更新され、性能向上だけでなく、様々な機能が搭載されました。スペック情報NVIDIA A100-PCIEと、NVIDIA V100S-PCIEのスペック比較です。TensorCore、FP16の性能が大きく伸びました。GPU型番NVIDIA A100-PCIENVIDIA Tesla V100S-PCIEアーキテクチャAmpereVoltaGPUベースクロック765 MHz1245 MHzGPU Boost...
HPC

NVIDIA A100 GPU製品が発表されました!

オンライン開催の GTC 2020( )にて NVIDIA CEO Jensen Huang氏 の Keynote がアナウンスされました。発表は NVIDIA YouTube Channel ( ) で 公開されています。プレイリストはこちらです。AIやデータサイエンス、HPC、自動運転やグラフィックなどに関する新情報が次々と出てきています。 NVIDIA A100 GPU。最新Ampere世代、TensorFloat32に対応し、Sparse Matrixに最適化された新たなTensorCore と 1.5TB/sの高帯域なHBM2を備え、PetaOPS級の性能。ますますDeep Lear...
DL

DGX-1 ベンチマークレポート

概要 先日、DGX-1を購入した記事を書きました。今回は、DGX-1を現在の他製品と比較したベンチマークを紹介します。ハードウェア環境 今回は、DGX-1と、HPC5000-XBWGPU10R4Sに NVIDIA® V100-PCIE(16GB)、RTX2080Tiを搭載して、比較します。ハードウェア環境は下表のとおり。表で分かる通り、RTX2080TiとNVIDIA® V100PCIEは、4枚しか持っていません。機種NVIDIA DGX-1HPC5000-XBWGPU10R4S搭載GPUNVIDIA® V100-SXM2RTX2080Ti、NVIDIA® V100-PCIE搭載GPU数(最大...
DL

DGX-1を手に入れた!

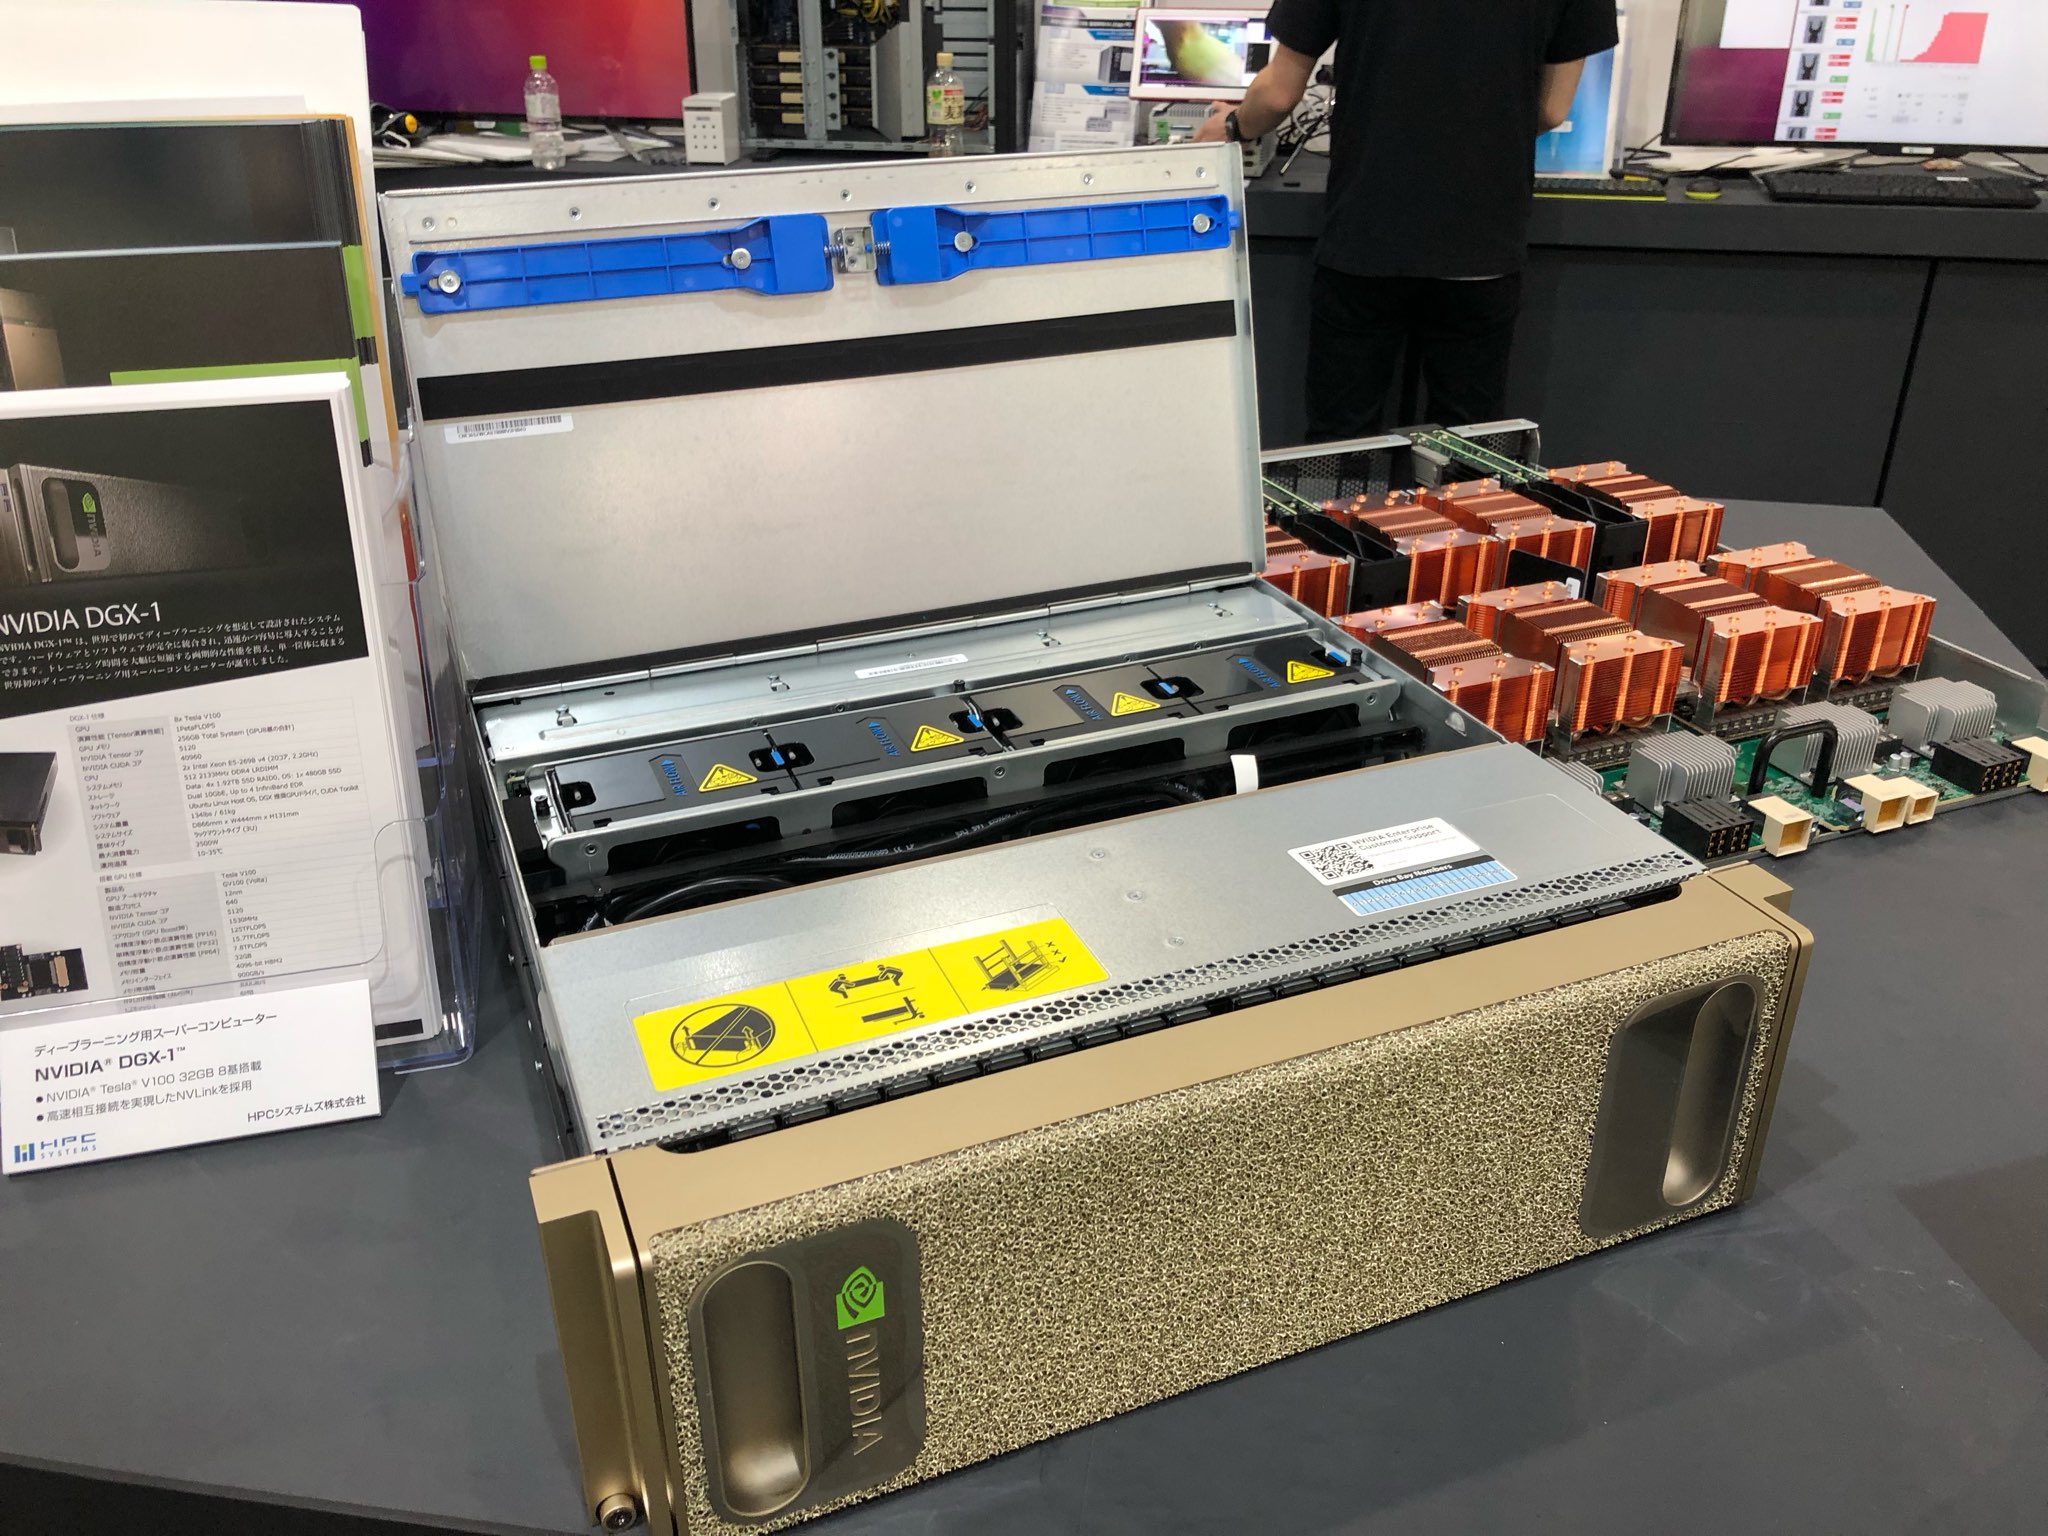
DGX-1@AI・人工知能EXPO 弊社にてDGX-2を取り扱うことになりました。それに伴い、弊社でDGX-1を購入しました。AI・人工知能EXPOでも展示してました(動作させるのに200V環境が必要なので、もちろん静態展示です)。弊社のブースでは、DGX-1の他に、OpenPoseなどを展示していました。 弊社のブース来て下さった方々、本当にありがとうございました。MLPerf せっかくDGX-1を手に入れたので、MLPerfというベンチマークを行うことにしました。 MLPerfとは、既定のモデルを、既定の性能まで、既定の方法で学習して、その時間を競うベンチマークです。機械学習の中でも、分散...