HPCシステムズではエンジニアを募集しています。詳しくはこちらをご覧ください。
HPCシステムズのエンジニア達による技術ブログ

Tech Blog

Deep Learning

HPC

自社サーバーでのLLMに挑戦!ローカルLLM+RAG環境を構築してみた

はじめに近年、生成AIや大規模言語モデル(LLM)の活用がビジネス・研究・開発の現場でも急速に進んでいます。しかし、「実際にどう使えばいいのか分からない」「技術的なハードルが高そう」「セキュリティ上のリスクが高い」「回答の確からしさが保証できない」と感じている方も多いのではないでしょうか。 本記事では、LLMの概要からセキュリティ・カスタマイズ性に優れたローカルLLMの実践、RAGの実装までを解説します。 大規模言語モデル(LLM)とRAG (Retrieval-Augmented Generation)とは大規模言語モデル(LLM)は、膨大な量のテキストデータを学習することで、人間の言語を理...
DL

L40S, H100 NVL上でのLLM推論学習検証報告

目的ローカルLLMを用いた生成AI活用に向けて、推論を中心としたパフォーマンス(体感速度、同時アクセス数)を明らかにすべく、ベンチマーク検証を行いました。ハードウェアの決定のために最低限必要な情報は「どのGPUを何枚で」どのモデルが動くかです。対象モデルは、現状精度の高い Llama 3.1 8B、Llama 3.1 70B、Gemma 2 9B、Gemma 2 27B としました。検証・結果 ユーザーの体感速度検証方法 各条件で1つのRequestを処理した際の、Throughput (token/sec) を計測 対象モデル:Llama 3.1 8B, Llama 3.1 70B、Gemm...
DL

高速なDNN学習計算のためのハードウェア構成ポイント

概要深層学習にGPUが好適とよく言われていますが、比較的安価なGPUからハイエンドのものまで様々なGPUがある中で、深層学習計算の高速化にどのようなハードウェア構成が適しているのでしょうか。GPUのスペックを見ると、理論性能値に加えてGPUメモリ容量、GPUメモリ帯域幅も様々ですし、複数GPU間の高速通信を可能とするNVLinkもあります。これらの選択肢がある中で、どの指標を優先的に考慮すべきなのでしょうか。本稿では、DNNの学習計算について、ベンチマーク結果からその答えを導いてみます。ベンチマーク環境本稿で用いるデータは弊社内で過去に取得したベンチマークからとなりますため、2024年現在の現...
DL

NVIDIA GH200 MLベンチマーク公開

NVIDIA GH200 の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、NVIDIA H100-PCIEと A6000 を加えた計3種のGPUで、機械学習の学習性能を比較評価しています。ベンチマーク報告書のダウンロードはこちら >>スペック情報NVIDIA GH200、NVIDIA H100-PCIE、NVIDIA A6000 のスペック比較表は次のとおりです。GPU型番NVIDIA GH200NVIDIA H100-PCIENVIDIA A6000アーキテクチャHopperHopperAmpereGPU ベースクロック990 MHzGPU Boost 時クロック1755...
DL

NVIDIA A800 MLベンチマーク公開

NVIDIA A800(40GB Active) の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、NVIDIA A100 を加えた計2種のGPUで、機械学習の学習性能を比較評価しています。ベンチマーク報告書のダウンロードはこちら >>スペック情報NVIDIA A800、NVIDIA A100 のスペック比較表は次のとおりです。GPU型番NVIDIA A80040GB ActiveNVIDIA A10080GB PCIeアーキテクチャAmpereAmpereGPUベースクロック765 MHz765 MHzGPU Boost時クロック2100 MHz1410 MHzCUDAコア...
HPC

AMDの新GPU Instinct™ MI300シリーズについて

AMDのAI 向け新GPU製品 Instinct MI300X および Instinct MI300Aの詳細が発表されました。 ネットでは取り上げられなかった 情報も交えて紹介いたします。■Instinct MI300Xについて図1 AMD Instinct MI300X 及び MI300AAMD InstinctMT MI300X は NVIDIA の H100 を凌駕するデータセンタ用の高性能 GPU です。すでに1月のCESの前日基調講演や6月の「Data Center and AI Technology Premiere」で発表されていましたが、今回サンノゼで開催された「AMD Adv...
DL

RTX A5500、RTX 5000 Ada MLベンチマーク公開

NVIDIA RTX A5500 と RTX 5000 Ada の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、これらのGPUに NVIDIA A6000 と RTX 4090 を加えた計4種のGPUで、機械学習の学習性能を比較評価しています。スペック情報NVIDIA RTX A5500、RTX 5000 Ada、RTX A6000、GeForce RTX 4090 のスペック比較表は次のとおりです。青文字は資料などからの推測値です。GPU型番NVIDIA RTX A5500NVIDIARTX 5000 AdaNVIDIARTX A6000GeForceRTX 4090アー...
DL

NVIDIA L40S MLベンチマーク公開

NVIDIA L40S の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、NVIDIA A100 を加えた計2種のGPUで、機械学習の学習性能を比較評価しています。ベンチマーク報告書のダウンロードはこちら >>スペック情報NVIDIA L40S、NVIDIA A100 のスペック比較表は次のとおりです。青文字は資料などからの推測値です。GPU型番NVIDIAL40SNVIDIA A100アーキテクチャAda LovelaceAmpereGPUベースクロック765 MHzGPU Boost時クロック2520 MHz1410 MHzCUDAコア数181766912TensorCo...
DL

NVIDIA H100, GeForce RTX 4090 MLベンチマーク公開

NVIDIA H100 と GeForce RTX 4090 の機械学習ベンチマーク報告書をこちらで公開しました。報告書の中では、これらのGPUに NVIDIA A100 と RTX 3090 を加えた計4種のGPUで、機械学習の学習性能を比較評価しています。スペック情報NVIDIA H100 PCIe、NVIDIA A100 PCIe、GeForce RTX 4090、GeForce RTX 3090 のスペック比較表は次のとおりです。CUDAコア数とGPU Boost時クロックが向上していることがわかります。GPU型番NVIDIAH100-PCIENVIDIA A100-PCIEGefor...
DL

NVIDIA® V100S vs A100™ Deep Learning Benchmarks

NVIDIA V100S PCIe 32GB とA100™ PCIe 40GB の Deep Learning 学習での性能評価のため、HPC5000-XCLGPU4TS (PCIe Gen3)とHPC5000-ERMGPU8R4S (PCIe Gen4)にGPUを1枚、2枚、3枚、4枚を実装して、nvidia/tensorflow:20.11-tf1-py3を実行してみました。製品名:HPC5000-XCLGPU4TSCPU Intel(R) Xeon(R) Gold 6242, CPUクロック 2.8 GHz, CPUコア 32, メモリ容量 192GB, 2933 MT/s   2.35...
HPC

NVIDIA A100 GPU製品が発表されました!

オンライン開催の GTC 2020( )にて NVIDIA CEO Jensen Huang氏 の Keynote がアナウンスされました。発表は NVIDIA YouTube Channel ( ) で 公開されています。プレイリストはこちらです。AIやデータサイエンス、HPC、自動運転やグラフィックなどに関する新情報が次々と出てきています。 NVIDIA A100 GPU。最新Ampere世代、TensorFloat32に対応し、Sparse Matrixに最適化された新たなTensorCore と 1.5TB/sの高帯域なHBM2を備え、PetaOPS級の性能。ますますDeep Lear...
産業用コンピューティング

産業分野における「ディープラーニング」と、その取り組み ~はじめての製品選びからハンズオン、構築まで

ここ数年、AI(人工知能)がブームになっています。グーグルが開発した「AlphaGo」が韓国のトッププロ棋士に勝利した「ニュース」を衝撃的に受け止めた方も多いと思います。AlphaGoは碁の対局に、「ディープラーニング(深層学習)」を用いたことで有名です。碁のように身近な応用例があるとはいえ、ご自身のビジネスとはまだ遠い世界だと感じている方も多いのではないでしょうか?しかし、既に多くのビジネス現場で、ディープラーニングを応用した技術が使われ始めています。第3次AIブームを支える技術/手法のひとつ 「ディープラーニング」とは?現在のAIブームは第3次になります。過去のAIブームとの大きな違いは、...
HPC

arXiv新記事を自動で見張らせてみた

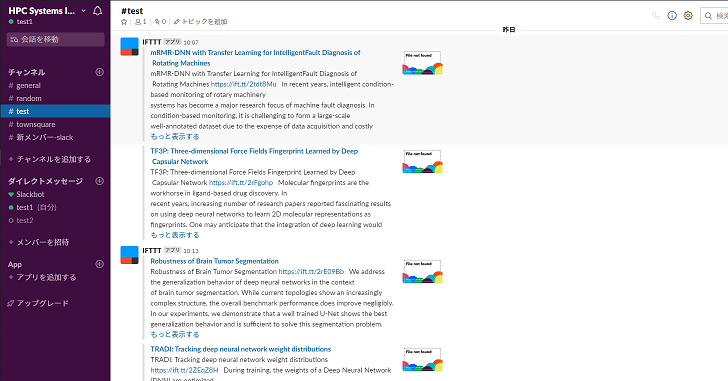
概要IFTTTの面白さを再発見し、作ってみました。arXiv(RSS feed) ⇒ IFTTT ⇒ Slack 、これでイメージできる方は、はい、それです。背景新しい学術情報の収集にarXivのプレプリントを見ている方は少なからずいらっしゃるでしょう。もちろん、それ以外の論文掲載サイトもたくさんありますが、大抵、更新があるかどうかは見に行かないとわからないし、それに、見に行ったけど更新がなくて残念ということもあるでしょう。更新があったときだけ高頻度に読むメディアに通知してくれたら便利ですよね。それも、自分の興味のあるキーワードに引っかかる更新だけについて通知してくれたら・・・。私(この記事の...
HPC

NGC(NVIDIA GPU CLOUD)のシステム要件および登録手順

NGC(NVIDIA GPU CLOUD)のシステム要件および登録手順
HPC

NGC(NVIDIA GPU CLOUD)の概要

NVIDIAが提供しているNGC(NVIDIA GPU CLOUD)の概要
DL

DGX-1 ベンチマークレポート

概要 先日、DGX-1を購入した記事を書きました。今回は、DGX-1を現在の他製品と比較したベンチマークを紹介します。ハードウェア環境 今回は、DGX-1と、HPC5000-XBWGPU10R4Sに NVIDIA® V100-PCIE(16GB)、RTX2080Tiを搭載して、比較します。ハードウェア環境は下表のとおり。表で分かる通り、RTX2080TiとNVIDIA® V100PCIEは、4枚しか持っていません。機種NVIDIA DGX-1HPC5000-XBWGPU10R4S搭載GPUNVIDIA® V100-SXM2RTX2080Ti、NVIDIA® V100-PCIE搭載GPU数(最大...
HPC

ノートPCでLinux

弊社では、お客様のご要望に応じてノートPCにLinuxをセットアップ※1しています。今回、新しいノートPC(MSI GS65 Stealth 8SF)※2にセットアップしました。※1 事前にご相談ください。※2 最新のRTX20(Turing)世代GPU搭載機です。すっごーい!普通にnvidia-docker2も動作しました。GPUのメモリも8GBありますし、DeepLearningもお手元で気軽に試せますね。ということで軽くスクリーンショットをご紹介します。本体は1.9Kgと高性能ノートでは軽量級ですが、ACアダプタは重量級です。しかも230W対応!MSI GS65 Stealth 8SFの...
DL

DGX-1を手に入れた!

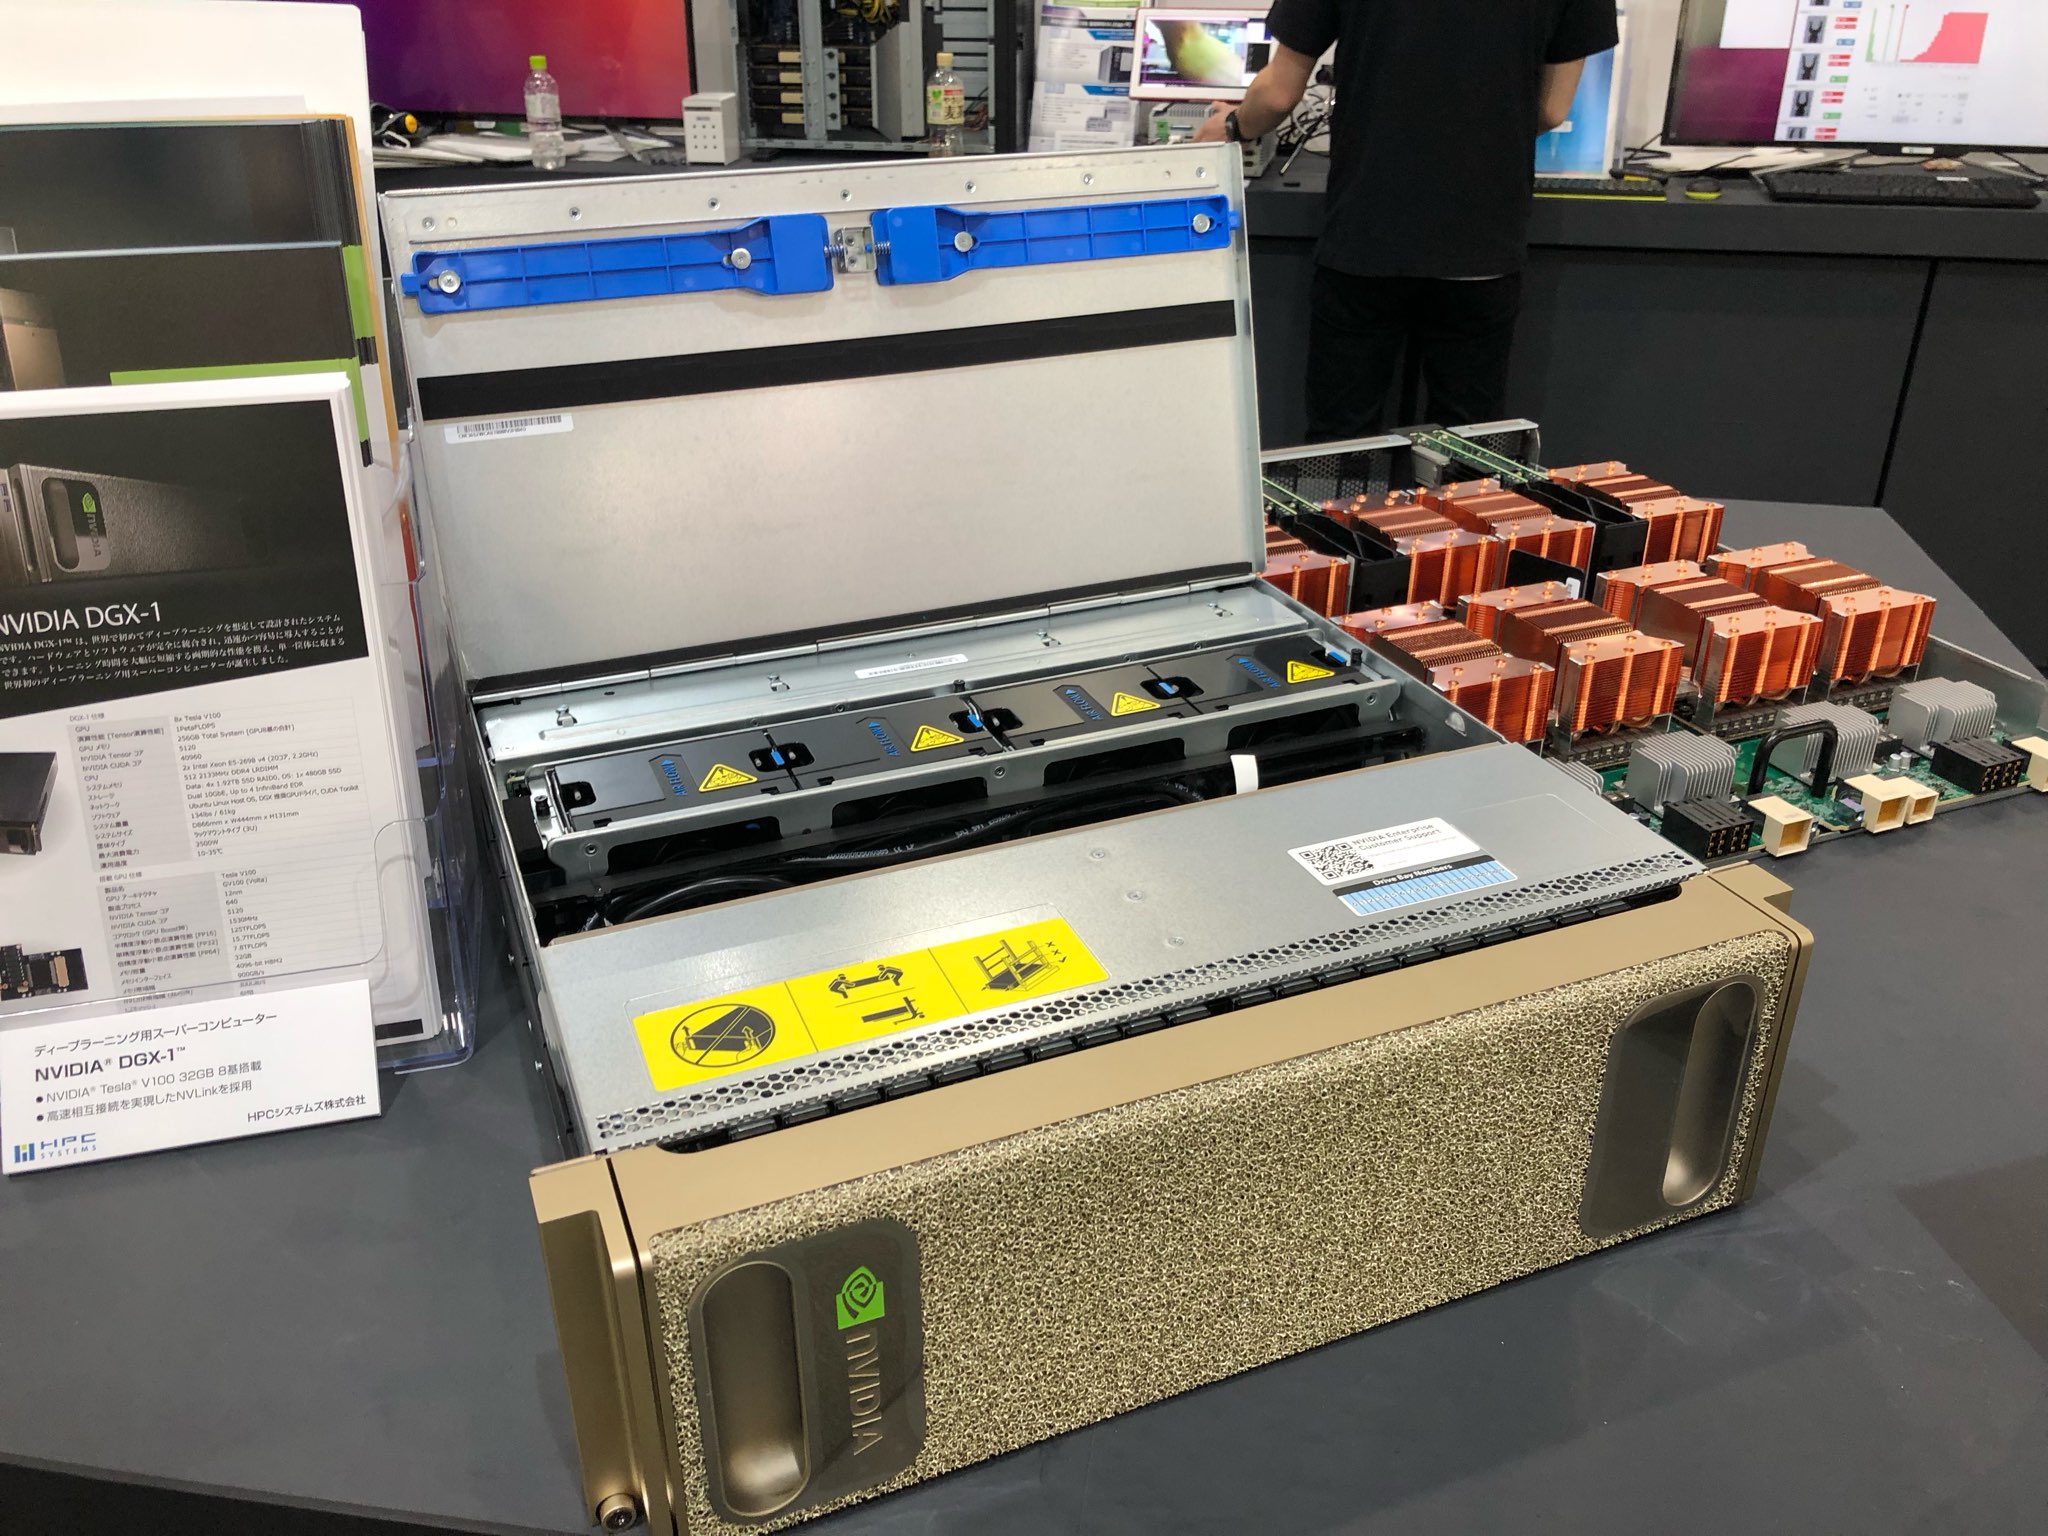
DGX-1@AI・人工知能EXPO 弊社にてDGX-2を取り扱うことになりました。それに伴い、弊社でDGX-1を購入しました。AI・人工知能EXPOでも展示してました(動作させるのに200V環境が必要なので、もちろん静態展示です)。弊社のブースでは、DGX-1の他に、OpenPoseなどを展示していました。 弊社のブース来て下さった方々、本当にありがとうございました。MLPerf せっかくDGX-1を手に入れたので、MLPerfというベンチマークを行うことにしました。 MLPerfとは、既定のモデルを、既定の性能まで、既定の方法で学習して、その時間を競うベンチマークです。機械学習の中でも、分散...
HPC

Deep Learning に対する Xeon 最適化の現状と将来(2019年4月)

US時間 4/2、日本時間 4/3 に第2世代 インテル® Xeon® スケーラブル プロセッサーがリリースされました。今回導入された新しい機能の一つに、Vector Neural Network Instruction(VNNI) があります。似たような位置づけの言葉として Intel® DL Boost がありますが、Intel® DL Boost は、インテルによる Deep Learning を加速する技術全体をあらわすマーケティング用語となっていて、執筆時点で該当するのは VNNI と bfloat16 です。初代インテル® Xeon® スケーラブル プロセッサー(Skylake)ま...