

コードの調査も、
修正も、テストも。
開発チームの手元にAIを。
繰り返し発生する開発作業を、手元のAIに任せる。
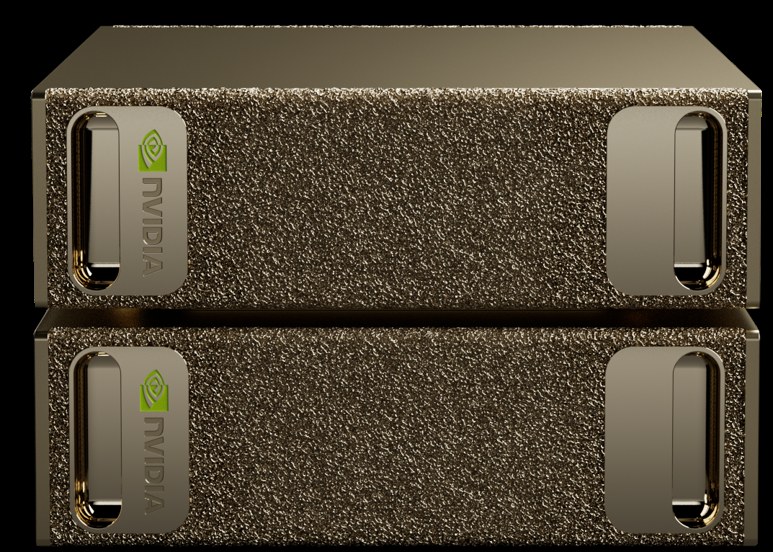
DGX Spark 2台構成で、
大型モデルを活用する自社専用の開発支援環境を検討しませんか。
- OWNモデルと実行環境を自社で持つ
- REPEAT日常の反復作業を任せる
- FIT自社のコードで適性を確かめる
CASE:不具合の原因を調べて、修正案を作成しテストを行いたい
関連コードを調べる
処理の流れ・依存関係・変更箇所を整理
「このAPIの呼び出し元と、変更時の影響範囲を整理して」
修正案の作成とテスト
差分を作成し、実行結果を確認
「このエラーを再現するテストと、修正案を作って」
人がレビューして判断する
提案の妥当性を確かめ、変更を採用
「この差分の概要と、レビュー時の確認事項をまとめて」
なぜいま、ローカルAIなのか。
無償でダウンロード可能なオープンモデルは、最新商用モデルに肉薄する性能を記録するようになりました。
「クラウドの最先端モデルでなければ使い物にならない」という前提は、すでに過去のものになりつつあります。
モデルの陳腐化は、
アップデートで解決する
新しいモデルが登場すれば、ソフトウェア面のアップデートで即座に対応可能です。モデル開発競争が激化する裏で、ダウンロードして使える優良モデルが次々と生まれ続けています。
初期投資だけで、
使い放題
クラウドAPIはトークン量に応じた従量課金と、利用集中時のレート制限がつきまといます。自社所有のDGX Sparkクラスタであれば、初期投資さえ済ませてしまえば、トークン消費量やアクセス集中を気にすることなく、AIエージェントを使い倒すことが可能です。
大切なデータを、
外部サーバーに渡さない
機密性の高い設計情報やソースコードを扱う場面でも、データを一切外部に渡すことなくAIエージェントを活用できます。
大型モデルを動かすためのメモリ容量を、
2台で確保。
開発者が判断に集中できるように。
調査や下準備が繰り返し発生する仕事から、導入効果を確かめます。
DGX Spark 2台構成で、DeepSeek V4 Flash FP8版の動作を社内検証しました。1台での搭載が難しいモデルを検討する際に、2台構成が選択肢になります。
選ぶ基準は、自社の作業で得られる回答品質と待ち時間。モデルの大きさだけで、業務への適性は決まりません。
回答を生成する速さ
60–80token/s
Decode速度。投機的デコードを使用。内容によって変動し、コーディング用途では高くなる傾向が報告されています。
入力を処理する速さ
約2,000token/s
Prefill速度。回答生成の前に入力を処理する性能の目安です。最初の回答までの時間とは異なります。
確保できたKVキャッシュ容量
100万超token
確保容量の報告値です。1件で入力できる長さ、実用的な応答時間、同時利用人数を保証する値ではありません。
※社内検証報告に基づく参考情報です。導入判断時は、お客様のコードを使ったタスク成功率、人による修正量、完了時間、同時利用時の応答をご確認いただくことを推奨いたします。
クラウドの仕事を、手元へ移す。
日常の調査や下準備をローカルで行い、難しいタスクにはクラウドも使う。
業務ごとの使い分けから、費用と使い勝手を評価します。
よくある課題
- AIへの依頼量が増え、従量課金を見直したい
- 社内コードを扱うAI環境を自社で管理したい
- 用途に合わせてモデルやツールを選びたい
導入前の確認事項
- 任せたいタスクの品質と、人の手直し量
- 同時利用する人数と、許容できる待ち時間
- 移せる利用量と、機器・電力・保守・運用費
DeepSeek V4 Flash インストレーションマニュアル付(インストール作業も別料金で承ります)
「この仕事に使えるか」から、
ご相談ください。
対象の開発業務、利用人数、現在のAIの使い方。
この3つから構成と検証内容をご相談いただけます。
お問い合わせ
平日9:30~17:30 (土曜日、日曜日、祝祭日、年末年始、夏期休暇は、休日とさせていただきます。)