

LOCAL LLM BENCHMARK REPORT
生成速度の差と、
同時利用の差。
RTX PRO 4500 Blackwell
vs.RTX PRO 6000 Blackwell Max-Q
単独の生成速度は近くても、利用が重なったときの待ち時間はどう変わるか。Qwen3.8-27Bを用いた実測から、KVキャッシュ容量と運用の違いを比較します。
Qwen3.8-27B-NVFP4 / vLLM 0.32.0 / KV NVFP4
16k入力・8並列の実測
生成中の差は約7%。
回答開始待ちは約7.8倍。
回答開始までのTTFT p95
秒・小さいほど良好
Pro 4500 / 32GB
53.16秒
Pro 6000 Max-Q / 96GB
6.79秒
生成中のTPOT p95:31.9 ms / 29.7 ms
Pro 4500 / Pro 6000 Max-Qの順
REPORT OVERVIEW
実測から見る、GPUの選び方。
Pro 4500は、少人数で使う生成速度を十分に確保できます。一方、長い入力や複数の要求が重なる条件では、Pro 6000 Max-Qの大きなKV領域が運用上の余裕につながります。
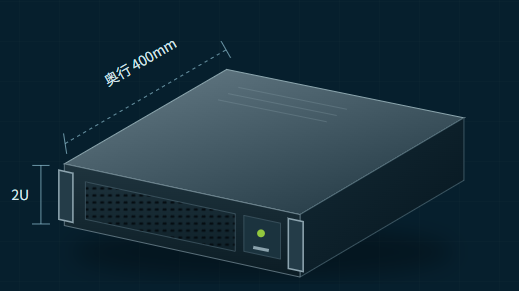
本レポートは、オフィスへの設置を想定した2U・奥行400mmのコンセプトモデルで実施しました。まずGPUの比較結果を示し、後半で評価に使った実機を紹介します。
01 / SINGLE-REQUEST DECODE
1人で使うと、
デコード速度の差は約16〜20%。
生成開始後の速さを示すTPOTを比較すると、今回のモデル・設定ではPro 4500も近い速度を示しました。個人利用や、同時処理数が少ない用途では、この違いをどう評価するかが選定の出発点になります。
| ワークロード(入力 / 出力tokens) | 4500 TPOT p95 | 6000 Max-Q TPOT p95 | 6000の速度比※ |
|---|---|---|---|
| Chat(1,024 / 256) | 23.3 ms | 19.5 ms | 1.19倍 |
| 業務文書QA(4,096 / 512) | 22.2 ms | 19.1 ms | 1.16倍 |
| RAG(8,192 / 512) | 22.5 ms | 19.4 ms | 1.16倍 |
| コード生成(32,768 / 4,096) | 19.4 ms | 16.2 ms | 1.20倍 |
TPOT:1トークンを生成する時間。小さいほど高速です。※4500のTPOT ÷ 6000のTPOT。GPUの演算性能全般の倍率ではありません。
02 / MEASURED PERFORMANCE
利用が重なると、
回答開始までの時間に大きな差。
単独のデコード速度に比べて、同時利用時の待ち時間には大きな差が現れました。生成中の速度と、順番待ちを含む回答開始までの時間を分けて比較します。
CASE 1 / 短いチャット
短いチャットを、16件同時に。
入力1,024 / 出力256 tokens
回答が始まるまでの時間
TTFT p95 / 秒・小さいほど良好(目盛り 0〜12秒)
RTX PRO 4500 32GB
10.16秒
RTX PRO 6000 Max-Q 96GB
3.01秒
回答開始待ちの差
3.4倍
生成中の速度は比較的近くても、回答が始まるまでの待ち時間は変わります。
| 同じ並列数での比較 | Pro 4500 | Pro 6000 Max-Q |
|---|---|---|
| 生成中のTPOT p95 | 30.5 ms/token | 29.3 ms/token |
| KVキャッシュ使用率 max | 90.1% | 16.7% |
CASE 2 / 長い文書の要約
16k入力の文書処理を、8件同時に。
入力16,384 / 出力2,048 tokens
回答が始まるまでの時間
TTFT p95 / 秒・小さいほど良好(目盛り 0〜65秒)
RTX PRO 4500 32GB
53.16秒
RTX PRO 6000 Max-Q 96GB
6.79秒
回答開始待ちの差
7.8倍
生成中の速度差は約7%。同時利用では、待ち時間に大きな差が出ます。
| 同じ並列数での比較 | Pro 4500 | Pro 6000 Max-Q |
|---|---|---|
| 生成中のTPOT p95 | 31.9 ms/token | 29.7 ms/token |
| KVキャッシュ使用率 max | 94.1% | 12.2% |
CASE 3 / コード生成
長いコード生成を、8件同時に。
入力32,768 / 出力4,096 tokens
回答が始まるまでの時間
TTFT p95 / 秒・小さいほど良好(目盛り 0〜160秒)
RTX PRO 4500 32GB
131.52秒
RTX PRO 6000 Max-Q 96GB
13.97秒
回答開始待ちの差
9.4倍
4500は生成を始めた要求の速度を保っても、順番を待つ要求が増えています。
| 同じ並列数での比較 | Pro 4500 | Pro 6000 Max-Q |
|---|---|---|
| 生成中のTPOT p95 | 28.6 ms/token | 31.5 ms/token |
| KVキャッシュ使用率 max | 99.0% | 16.1% |
Qwen3.8-27B-NVFP4 / vLLM 0.32.0 / KV NVFP4。本ページ後半で紹介する2U・奥行400mmのコンセプトモデルで実施したGPU比較の結果です。
実測値の見方・評価条件
TTFTは回答開始までの時間、TPOTは生成開始後の1トークンあたりの時間です。p95は、計測要求の95%がその値以下となる目安です。並列数は同時処理要求数であり、登録ユーザー数とは異なります。
KV使用率は各構成の割当領域に対する割合です。KV圧迫と待機増加の相関が見られますが、応答差をKV容量のみの効果として分離した試験ではありません。両GPUのSLOは未設定で、快適に使える上限人数は未確定です。
単独利用時の速度差は、Chat・業務文書QA・RAG・コード生成のTPOT p95の逆数による比較です。評価実機のハードウェア構成は本ページ後半に掲載しています。評価条件の詳細は後日追加予定です。
03 / KV CACHE & QUEUE
生成を続ける速さと、
次の要求を受け入れる余裕。
Pro 4500のChatでは、8並列から16並列に増やしても、全体の処理量はほぼ頭打ち。一方、回答開始までの時間は2.64秒から10.16秒へ増加しました。
| 並列数 | 4500 全体の出力 | 6000 Max-Q 全体の出力 | 4500 TTFT p95 | 6000 Max-Q TTFT p95 |
|---|---|---|---|---|
| 4 | 176.0 tok/s | 212.5 tok/s | 0.56秒 | 0.32秒 |
| 8 | 264.9 tok/s | 377.4 tok/s | 2.64秒 | 1.57秒 |
| 16 | 272.6 tok/s | 615.6 tok/s | 10.16秒 | 3.01秒 |
| 32 | 271.5 tok/s | 806.6 tok/s | 25.40秒 | 4.40秒 |
入力1,024 / 出力256 tokens。出力処理量は全要求の合計。並列数は登録人数ではなく、同時処理要求数です。
モデルを載せた後に、
どれだけ余裕が残るか。
GPUメモリはモデルの重みや実行用メモリにも使います。同じモデルを動かしても、32GBと96GBではKVキャッシュに回せる余裕が変わります。
同じ負荷におけるKV使用率は、Chat・4並列で51.5%と4.2%、コード生成・4並列で99.0%と8.0%でした。Pro 4500は早い段階でKV領域の圧迫が見られます。
実行中の要求の生成速度が保たれていても、待機する要求が増えると、利用者全体の待ち時間は長くなります。KV使用率と待機を、生成速度と併せて見る必要があります。
96GBの余裕と、処理能力の限界は別に確認
Pro 6000 Max-Qでも、RAG・16並列ではKV使用率maxが20.2%ながら、TTFT p95は13.34秒でした。実用上の並列数は、入力の長さと、許容するTTFT・TPOTを決めたうえで判断します。
KV使用率は各構成の割当領域に対する割合です。実際のKV割当容量は未取得のため、容量の倍率は断定しません。応答差をKV容量だけの効果として分離した試験ではありません。
04 / RIGHT-SIZING
Pro 4500でよい場合も。
Pro 6000を勧めたい場合も。
「何人が登録するか」に加え、「どんな処理が何件重なるか」で考えます。
32GB VRAM
RTX PRO 4500 Blackwell
少人数で、利用範囲を決められる運用に。
- 短いチャットを主に1〜4件ずつ処理
- 文書整理・要約を順次処理
- 長いコード生成を主に1〜2件ずつ実行
実測例:Chat・4並列のTTFT p95 0.56秒
96GB VRAM
RTX PRO 6000 Blackwell Max-Q
部門共用や、長い処理が重なる運用に。
- 複数人のチャット利用が重なる
- 長い業務文書の要約・分析を共用する
- 開発支援で長い入力とコード出力が重なる
実測例:Chat・16並列のTTFT p95 3.01秒
用途別の選定例です。人数や応答時間の保証ではありません。ご利用データ・入力長・出力長・許容待ち時間を踏まえてご相談ください。
05 / TEST HARDWARE
評価に使った実機は、
オフィスに置くための
2Uコンセプトモデル。
ここまでのGPU比較は、このコンセプトモデルで行いました。Pro 4500 BlackwellとPro 6000 Blackwell Max-Qの両構成を評価しています。
BMCによる管理機能を備え、CPUはRyzen、メモリは通常のDDR5、電源はSFXを採用。実測で性能を確認しながら、構成費用を抑える設計です。
OFFICE LOCAL LLM 2U CONCEPT
NVIDIA RTX PRO 6000 Blackwell Max-Q
96GB VRAM × 1 GPU
筐体図は構想イメージです。実機写真は後日掲載予定です。
MEASURED CONFIGURATION
管理機能を備えながら、
構成費用を抑える設計。
CPUにはコンシューマー向けのAMD Ryzenを、メモリには通常のDDR5を採用しました。BMCを備えたラックマウント機としての管理機能と、LLM推論での実性能・費用のバランスを考えた構成です。
Pro 6000 Max-Q構成・連続LLM負荷時
46dB実測値
周囲騒音が約30dBの当社会議室で、実機から1mの距離で測定。LLMの負荷をかけ続けたときの音を確認しました。
一般的なオフィスビル内の一室での測定です。
電源面の備えは、設置環境に合わせて。
本機はSFX 1100W電源を採用する構成です。停電・瞬停への備えが必要な場合は、外付けUPSを別途用意する運用を想定しています。
本レポートの評価実機 / 製品化検討中
16コア / 32スレッド
64GBまたは128GBを推奨
Max-Q × 1基(96GB)
一般的なオフィスビル内の一室
SSD容量や評価ソフトウェア、負荷条件の詳細は後日追記予定です。1100Wは電源の定格容量です。
INQUIRY
評価に使ったこの構成に、
興味はありますか。
「同じ構成で使ってみたい」
「オフィスに置けるLLM基盤を検討している」
用途やご要望を添えて、お気軽にご相談ください。
本機はコンセプトモデルのため、納期やセットアップ内容などに条件がありますが、お見積もりの提示は可能です。
HPCシステムズの公式お問い合わせフォームへ移動します。
QUESTIONS
お問い合わせの前に。
いま購入できますか?
コンセプトモデルのため、納期やセットアップ内容などに条件がありますが、お見積もりの提示は可能です。ご希望の構成や用途を添えて、公式お問い合わせフォームからご相談ください。
何人で使える構成ですか?
入力する文書の長さ、出力の長さ、同時処理数、許容する待ち時間によって変わります。実測比較の並列数をそのまま保証人数としてご案内するものではありません。想定用途を添えてご相談ください。
46dBはどのような環境で測定しましたか?
46dBは、Pro 6000 Max-Q構成にLLMの連続負荷をかけ、周囲騒音が約30dBの当社会議室で、実機から1mの距離で測定した値です。測定場所は、一般的なオフィスビル内の一室です。
03-5446-5531
平日9:00~18:00(土・日・祝日は除きます)
※土曜日、日曜日、祝日、年末年始は、休日とさせていただきます。
